只问了一句话,为什么用了这么多 token?
让 AI 帮忙看一个 Bug,只发了一句“这个测试为什么失败”,结果用量里出现了几千甚至更多 token。
看着输入框里的十几个字,很容易觉得对不上。
原因通常是:模型这次收到的内容,比输入框里这句话多得多。尤其是编程 Agent,它还要读取规则、查看代码、执行工具,可能来回请求模型好几次。
这篇就拆开一次找 Bug 的过程,看看 token 都用在了什么地方。
1. token 和字数,先不要混着算
token 是模型处理内容时使用的计量单位。对于文本,分词器会把文字拆成一串 token。
它可能对应一个字、一个词的一部分,也可能覆盖多个字符。中文、英文、代码、标点使用的切分方式不一样,不同模型的分词器也可能不同。
所以,“一千字等于多少 token”只能做粗略估计。要知道实际请求用了多少,应该看对应模型的计数工具和请求返回的用量。
另外,图片、音频等输入也有各自的计量方式。文件只有几百 KB,并不能直接推算它对应多少 token。
下面先只看文本和工具调用。所有数字都用于说明计算关系,不是实际跑出的用量。
2. 输入框里的内容,只占一部分
假设你说:“帮我看看登录测试为什么失败。”
Agent 准备分析之前,可能已经带上了这些东西:
| 输入内容 | 这次示例中的 token 数 |
|---|---|
| 系统指令和项目规则 | 800 |
| 你刚发的要求 | 30 |
| 之前的对话和工作记录 | 2,200 |
| 可以调用的工具说明 | 1,000 |
| 已读取的代码和测试输出 | 3,000 |
| 合计 | 7,030 |
注意,工具说明和工具结果是两种东西。
工具说明告诉模型“有哪些工具、需要什么参数”;工具结果则是“刚才读文件或者执行命令,实际拿到了什么”。两者都可能进入输入。
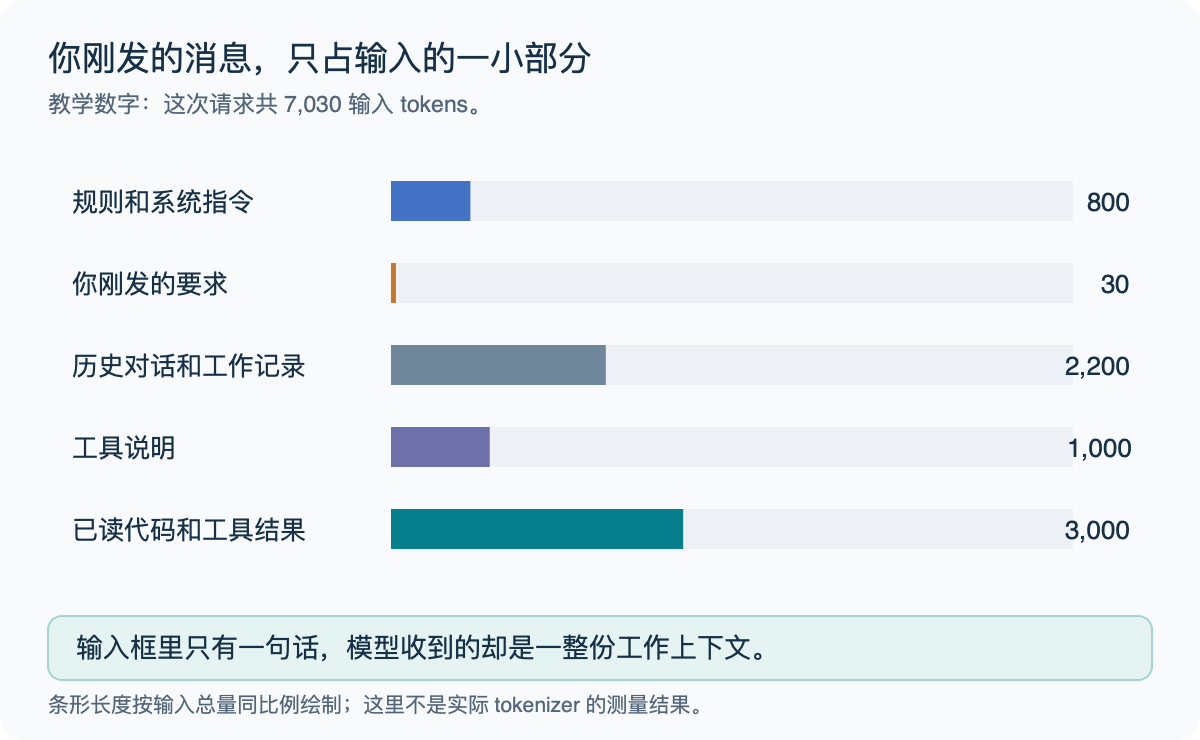
这就能解释为什么只说了一句话,输入用量却很大。真正送给模型的,是这次工作需要的整份上下文。
当然,实际应用不一定把所有工具和历史完整带入。有的会按需加载,有的会裁剪或者压缩。上面的表格是拆解方法,不是所有产品的固定组成。
3. 你的一次任务,可能包含很多次模型请求
继续看找 Bug 这个例子。
Agent 可能先请求模型,决定读取测试文件;工具返回内容后,再请求模型分析;然后读取实现代码,修改文件,运行测试,再判断有没有修好。
你只提了一次要求,后台已经走了多轮。
而前一轮的输出、工具调用和返回结果,又可能进入下一轮的输入。历史保留得越多,后面每一轮需要处理的内容就可能越长。
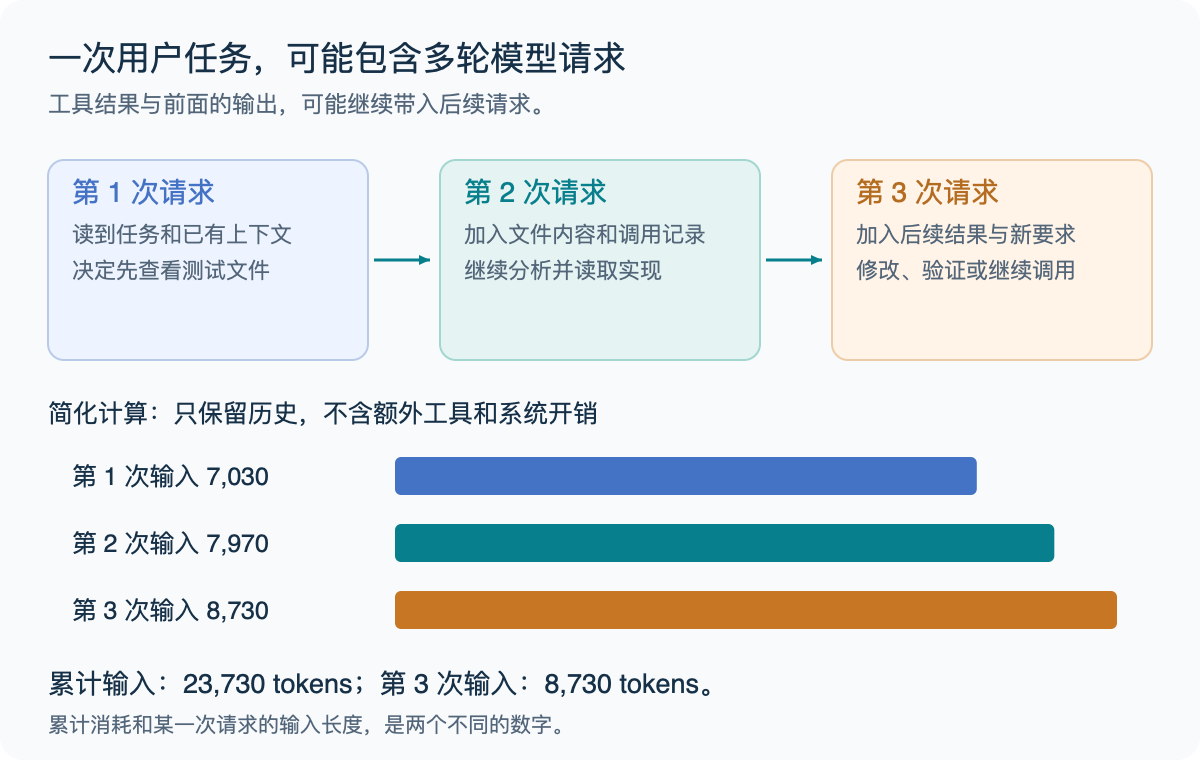
为了看清楚重复输入,先把工具过程省略,假设只有三次请求:
1 | |
这里的 40 和 60 是后续新增内容的示意值。也假设历史全部保留,没有压缩,没有额外系统开销。例子中的输出,指会保留到后续上下文中的内容;不同接口单独统计的推理开销,暂不计入这里。
三次输入累计就是:
1 | |
但第三次请求的输入只有 8,730 tokens。
累计用了多少,和当前窗口里有多少,是两个数字。 把它们混在一起,就会误以为一次请求已经超过了窗口容量。
有些 API 允许只传会话标识或者上次响应标识,由服务端接续历史。这样可以少传网络数据,但后续仍然可能处理历史内容,不能只按这次请求体里新增的几行字估算用量。
4. 缓存命中,到底省了什么
既然历史反复出现,那前面处理过的内容能不能重复利用?
Prompt Cache 主要就在处理这类问题。满足条件时,服务可以复用已经处理过的输入前缀,降低重复计算的成本和耗时。
这里的前缀,可以简单理解为输入开头连续的一段内容。能不能命中,还要看服务的缓存规则、配置、有效时间和内容是否匹配。
缓存命中,不等于这部分内容从上下文里消失了。
例如某次输入一共 8,000 tokens,其中 6,000 命中缓存,另外 2,000 没有命中。模型使用的输入仍然是这 8,000,只是不同部分可能按不同方式处理和计费。
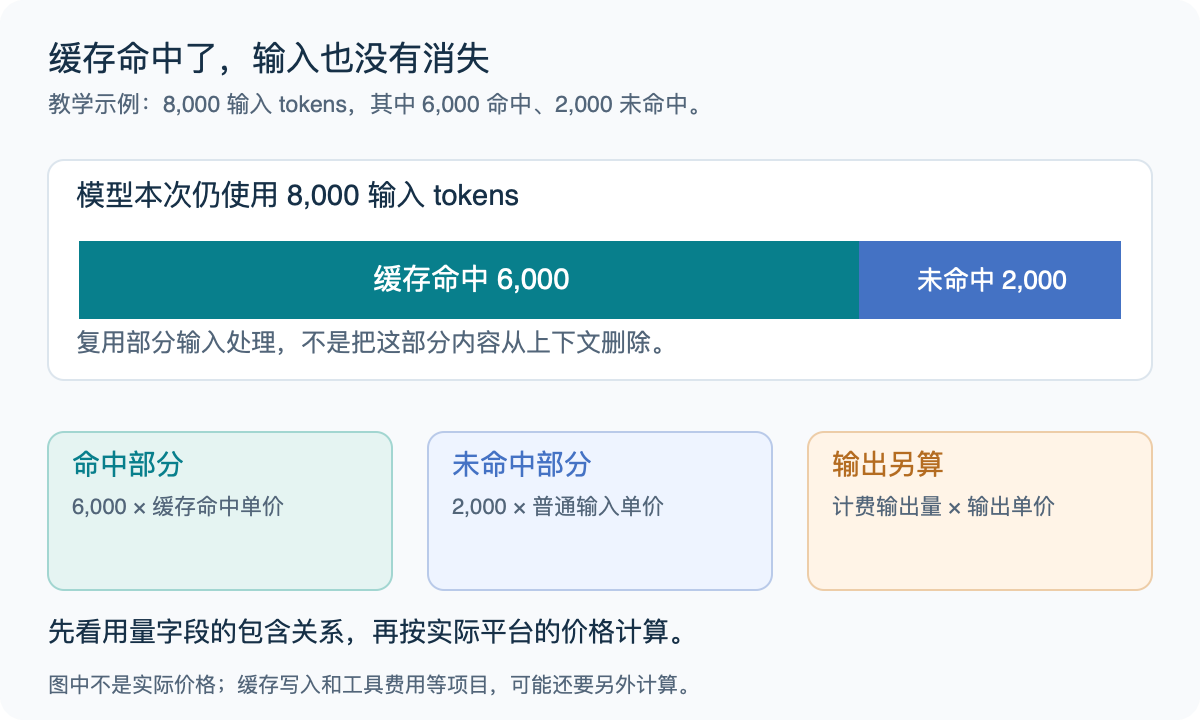
对于把输入区分成“缓存命中”和“未命中”的计费方式,可以先用下面的公式理解:
1 | |
输入量和单价要使用同一单位。比如价格按每百万 token 标注,计算前就要除以一百万。
有的平台还会单独计算缓存写入,或者提供不同的缓存保存时间。工具调用也可能有额外费用。因此,这个简式不能直接替代各个平台的账单规则。
另外,缓存一般复用的是输入处理,不是保证“同样的问题直接拿上次答案”。后面的回答仍然可能重新生成。
5. 看用量时,先确认这些口径
如果用的是 API,可以从返回的用量字段开始查。字段名和包含关系会随接口变化,但下面几个问题值得先确认:
- 输入 token 是本次总输入,还是只包含某一部分?
- 缓存命中是总输入的子项,还是与普通输入分开列出的?
- 输出统计有没有包含推理相关的 token?
- 看到的是单次请求,还是一个 Agent 任务的累计用量?
- 是否另外收取搜索、代码执行等工具费用?
比如某个接口已经把缓存命中算进了输入总数,你再把两项相加,就会重复计算。另一些接口则把缓存写入、读取和普通输入分开给出,应该按各自定义统计。
同样,屏幕上只显示一小段答案,也不代表输出用量就只有这一小段。推理模型可能还有没有直接展示的处理过程,具体怎么统计,要看接口规则。
如果使用的是按月订阅的聊天产品,还要把套餐额度和 API 账单分开看。界面里的用量比例,不能直接换算成一次 API 请求花了多少钱。
6. 想减少无效消耗,可以先改这几个地方
6.1 给出范围,让 Agent 少绕一点路
“看看哪里有问题”和“登录测试失败,先看这个测试文件和对应实现”,需要的搜索范围不同。
知道错误入口,就把文件名、报错和复现方式说清楚。这样既方便定位,也减少无关的文件读取。
6.2 工具输出按需要取,但保留完整原文
查一个函数,先看相关代码;看测试失败,优先保留失败用例、错误和必要上下文。没必要每次把整个依赖目录或者所有通过用例都交给模型。
但也别为了省 token,把关键错误裁掉。完整日志可以保存在文件里,模型需要时再读取具体位置。
6.3 稳定内容保持稳定
项目规则、常用工具说明等内容,如果本来就没变,不必每次随意改写和重排。对于依赖前缀匹配的缓存,这样更容易复用已有内容。
这仍然要配合所用服务的缓存机制,不能仅靠“内容放前面”就保证命中。
6.4 看整个任务,不只盯着某一次请求
少读几行代码,可能省下一点输入;如果因此理解错了,后面多改两轮、多跑几次测试,总消耗反而更大。
实际比较时,把完成同一任务的总请求数、总用量、耗时和结果放在一起看。只要输入都对完成任务有用,就不必为了追求一个更小的数字,把必要信息删掉。
以上。完结撒花 🎉!