聊聊 Agent 的上下文压缩:对话太长了,怎么接着干活?
用 Codex 或者 Claude Code 做一个稍微长一点的任务,中间会读文件、改代码、跑测试,还可能来回试几种方案。这些内容都会占用上下文。一直聊下去,窗口总会有装不下的时候。
这时就需要做上下文压缩,也就是经常看到的 Compaction。
压缩完以后,Agent 还能继续工作。但前面说过的要求、试过的方案,还有没做完的事情,到底留下了多少?这篇就拿 Codex、Claude Code 和 DeepSeek Harness 来看一下。
1. 上下文里装的,不只是聊天记录
平时在界面上看到的是你一句、AI 一句。到了编程 Agent 这里,一次任务还会带上很多其他内容:
- 系统指令和项目规则。
- 可以调用的工具,以及工具的参数说明。
- 读取过的代码、命令输出、报错和测试结果。
- 已经讨论过的方案,以及你后来补充的要求。
这些内容放进模型本次处理的窗口里,都要占空间。这个空间通常用 token 来计算。先把 token 理解成模型处理文字等内容时使用的计量单位就行,它和字数不是一一对应的。
比如你只说了一句“帮我看看测试为什么失败”,工具却返回了几千行日志。你没有聊多少句,上下文可能已经增加了一大截。
这里先分清三个东西:
| 名称 | 可以怎么理解 |
|---|---|
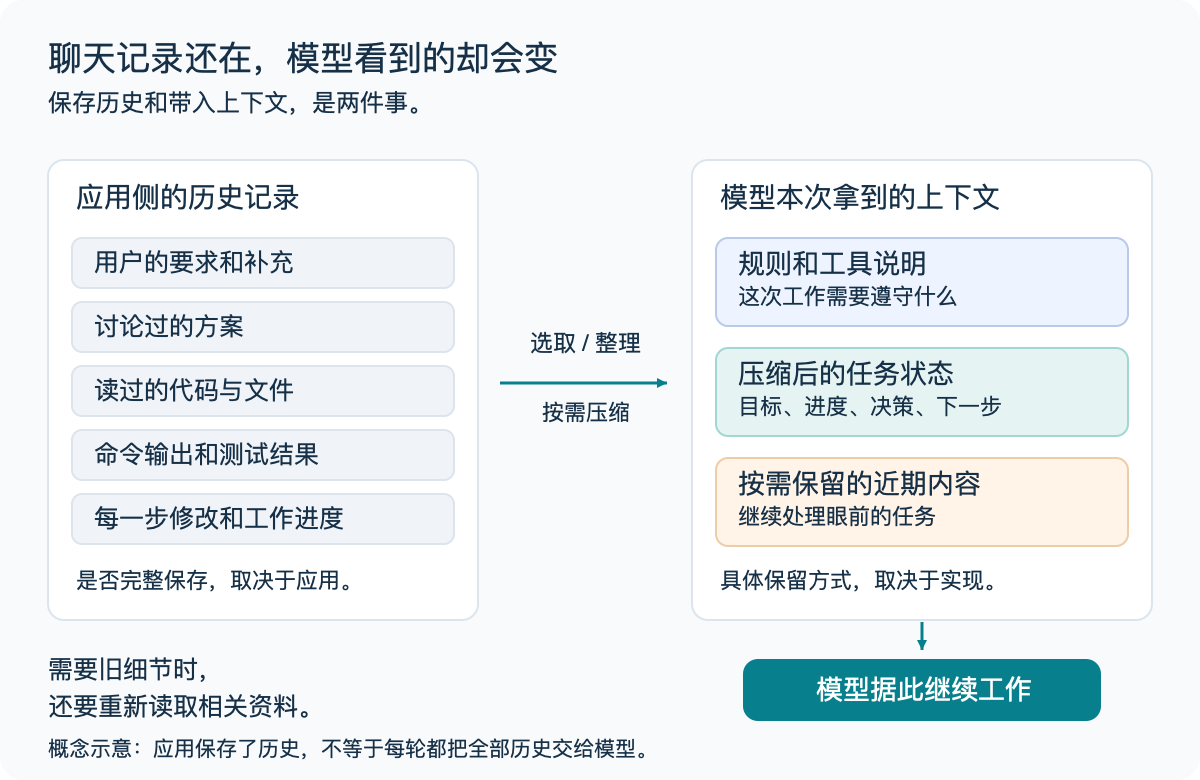
| 完整会话记录 | 应用保存的聊天和工具记录,具体保存哪些取决于应用 |
| 当前上下文 | 模型这一次真正拿到的内容 |
| 持久记忆 | 应用在后续会话中保存、查找和带入的信息 |
记录保存在应用里,不代表模型每次都会把它们全部看一遍。
你可以把上下文想成一张工作台。文件柜里可以放很多资料,桌面能摊开的东西是有限的。桌面满了,就要把旧资料整理一下,留下接下来还要用的部分。
上下文压缩做的就是这件事。它把一部分历史换成更短的内容或状态,让后面的任务还有空间继续。
2. 压缩以后,应该留下什么
下面用一个修 Bug 的例子来解释,方便看清楚压缩前后应该留下什么。
假设让 Agent 修复一个登录问题:两个请求同时收到 401,各自去刷新 token,导致重复刷新。要求也很明确:
只处理同一个 JavaScript 运行环境里的并发。保持公开 API 不变,不加依赖,不要把 token 写进日志。
中间讨论过用 localStorage 加锁,但这个方案被否定了。因为它会把多标签页协调、锁过期和崩溃恢复都带进来,超出了这次修改范围。
后来 Agent 改成复用一个正在进行的刷新 Promise,也就是 inFlightRefresh。第一次测试又失败了:
1 | |
原因是失败后的 Promise 没有清掉,后面继续复用它,新的刷新没有发生。
接着,Agent 补了失败后的清理逻辑。代码已经改了,但还没重新跑测试。 这时候开始压缩上下文。
如果只留下这么一句:
1 | |
接下来就很难判断具体进度。测试有没有通过?为什么不用锁?还有没有范围限制?都没写清楚。
一份能接着干活的交接内容,可以写成这样:
1 | |
这里保留下来的,是目标、限制、进度、失败证据和下一步。重复的目录列表、安装进度、过时的代码副本,可以少占一点位置。
“改过了”和“验证通过了”,这两个状态一定要分开。 少了这句话,后续就可能把待验证的修改当成已经完成。
还有一个容易漏的点:被否定的方案也有用。只记住最后选了什么,不记住前面为什么排除了某个方案,后面可能又绕回去。
上面是方便理解的交接示例。不同产品的真实压缩结果,不一定长成这样的文本。
3. 一次压缩,大概会做哪些事
Agent 后面有一套程序,负责调用模型、执行工具和管理会话,通常叫 harness。什么时候压缩、留下哪些内容,要看这套程序怎么处理。有些工作也会交给模型服务端完成。
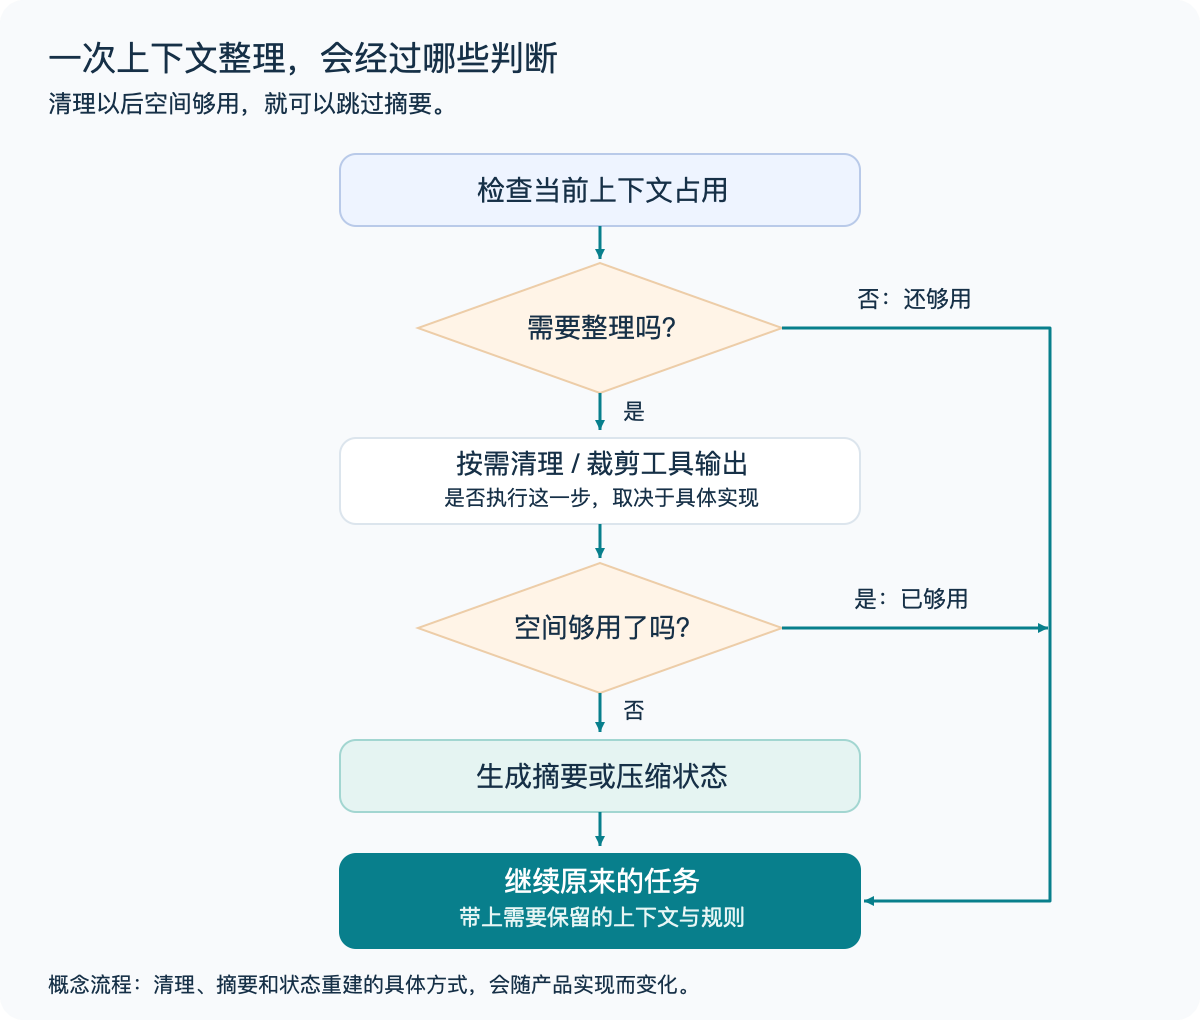
下面这个流程用来理解整体过程,具体产品可以省略或调整其中的步骤:
3.1 先减少工具输出
有些输出本身就很长。比如一段安装日志,头部是执行信息,尾部是结果,中间有大量重复内容。
一种处理方式是保留头尾,省略中间。这种裁剪不一定需要调用模型,处理起来比较直接。
但它也有问题:如果关键报错刚好在中间,就会一起被省略。所以工具结果变短了,并不能说明重要信息都留下了。
3.2 再整理任务状态
如果裁剪以后仍然太长,就需要对旧历史做进一步处理。文本摘要会尝试提取目标、进度、决策等信息;有的服务则返回供模型继续使用的不透明状态。
可以被替换的范围也有要求。比如前面有一条工具调用,后面有对应结果,不能随便从中间截断,留下一个对不上调用的结果。
近期内容怎么保留、项目规则怎么重新带入,也要看具体实现。不能简单理解为“所有产品都删掉前半段,留下最后十轮”。
3.3 压缩需要提前留空间
假设一次输入里有这些内容,数字只是演示:
1 | |
如果把较早的工作记录整理成 8,000 tokens 的状态,新输入就是:
1 | |
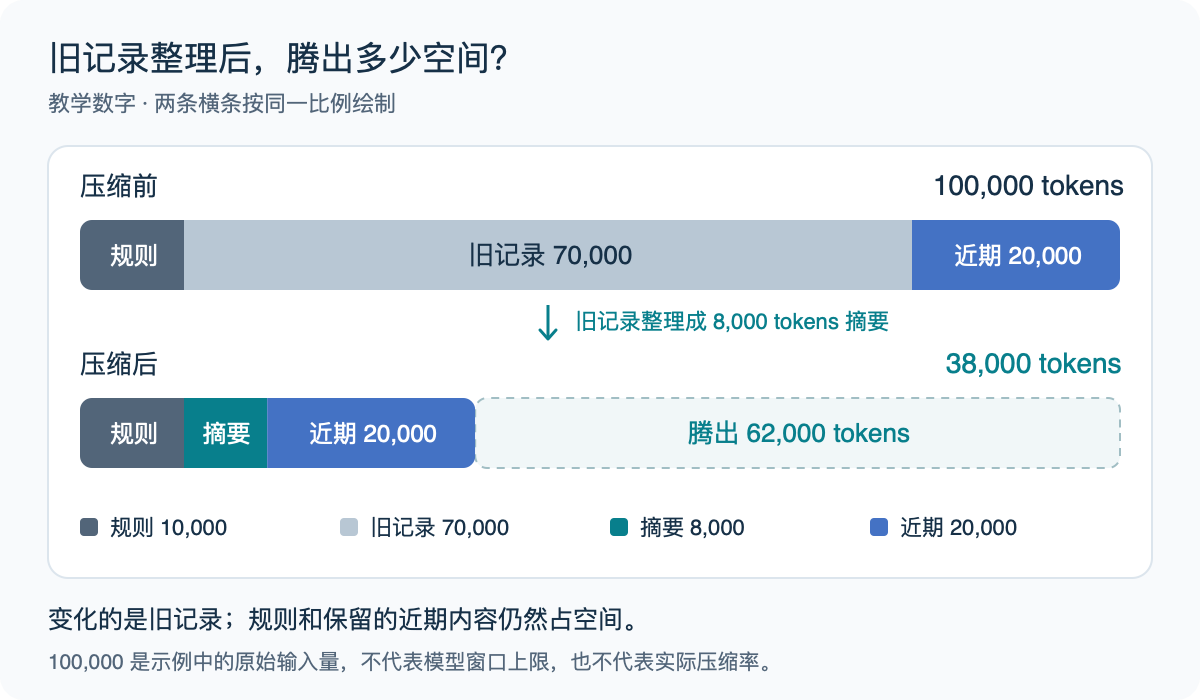
腾出来的是旧记录和新状态之间的差额。固定规则、保留的近期内容,仍然占空间。
另外,还要给模型输出和后续工具返回留余量。OpenAI 的独立压缩接口就明确要求,送去压缩的原始窗口仍然要能放进模型里,不能一直等到装不下才调用。
4. Codex、Claude Code 和 DeepSeek Harness 分别怎么做
4.1 Codex:本地摘要和远程压缩都有
Codex 的公开配置区分了本地压缩和远程压缩能力。使用哪条路径,要看 provider、模型和相关设置。自动压缩的 token 阈值也可以配置,未设置时使用模型默认值。
先看本地这条路径:让模型整理一份文字摘要,再重新组织输入。公开的摘要指令要求留下当前进度、关键决策、用户约束、待办和继续工作需要的资料。这和前面写交接记录的思路接近。
远程这边,可以先看 OpenAI Responses API 公开的压缩接口。它会返回 compaction 项目,其中有 encrypted_content。这个内容是不透明的,不能当作普通文字摘要直接阅读,也不能据此猜测里面一定是什么数据结构。
调用独立的 /responses/compact 后,返回结果里还可能有保留的其他项目。继续请求时,要把完整的 compacted.output 原样带入,再追加新输入。不要只拿出 encrypted_content,把其他部分丢掉。
Responses 另外也支持在正常请求里配置阈值,由服务端触发压缩。这和主动调用独立接口是两种使用方式。
这里说的是 Codex 和 Responses API。普通 ChatGPT 的长对话怎么处理,不能直接照搬这套说明。它的记忆功能也要分开看。
4.2 Claude Code:先清理旧输出,需要时再摘要
Claude Code 的处理顺序是:先清除较早的工具输出,需要时再总结对话。你也可以用 /compact 主动整理,并说明希望保留的重点。
比如在前面的登录问题里,可以这样写:
1 | |
这个提示是在告诉它哪些信息重要,实际结果仍然需要检查。
Claude Agent SDK 使用同一套 agent loop。发生压缩时,SDK 会发出 compact_boundary 事件,应用可以知道这里进行过一次压缩。它会对较早历史做摘要,保留近期交流和关键决策。
如果你自己用 SDK 接项目规则,还要留意 settingSources。CLAUDE.md 需要通过对应设置加载,加载后会重新注入请求。不能只把文件放在那里,就默认所有 SDK 程序都会读取它。
至于什么时候触发,不同模型和部署会有区别。终端版本还记录过与空闲时间、缓存寿命有关的压缩行为,所以不要把网上某个固定百分比当成所有版本的规则。
另外,Claude API 还有独立的按需压缩、阈值压缩机制。API 返回块和参数的规则,应当按对应接口看,不能直接当成 Claude Code 内部摘要的格式。
4.3 DeepSeek Harness:可以直接看交接格式和替换过程
这里讨论的是官方开源的 DeepSeek Harness,下面简称 DSH。范围是这套运行程序,不能由此推断 DeepSeek 网页聊天也使用相同机制。
DSH 的 compaction-basic 会检查上下文压力。触发压缩后,如果启用了工具结果裁剪器,会先裁剪,再重新计算。空间已经够用,就可以跳过后面的摘要调用。
这个裁剪器的默认规则比较具体:文本超过 8192 个 Unicode 码点时,保留头部 4096 个和尾部 1024 个,中间加入省略标记。这里计算的是字符层面的长度,不是 token 数;裁剪器本身也不需要模型生成摘要。
如果仍然需要压缩,就选取较早、可以安全替换的历史,让模型生成检查点。它的提示词规定了八个部分:原始请求、技术概念、文件和代码、错误与修复、待办、当前工作、下一步、关键上下文。
这些内容使用英文整理,放进 <compacted-summary>。路径、命令、错误、用户纠正等细节要求尽量准确保留。已有的旧摘要也要和新进展合并,过时的状态需要更新。
DSH 还有一个值得单独说的地方:模型看到的内容被替换了,原始事件仍然留在日志里。 实现里把模型可见的那份内容叫作 surface。压缩主要调整这份内容,完整事件日志继续保留。
因此,日志还在和当前输入变短,可以同时发生。需要旧细节时,还得通过相应工具把资料找回来。
4.4 放在一起看
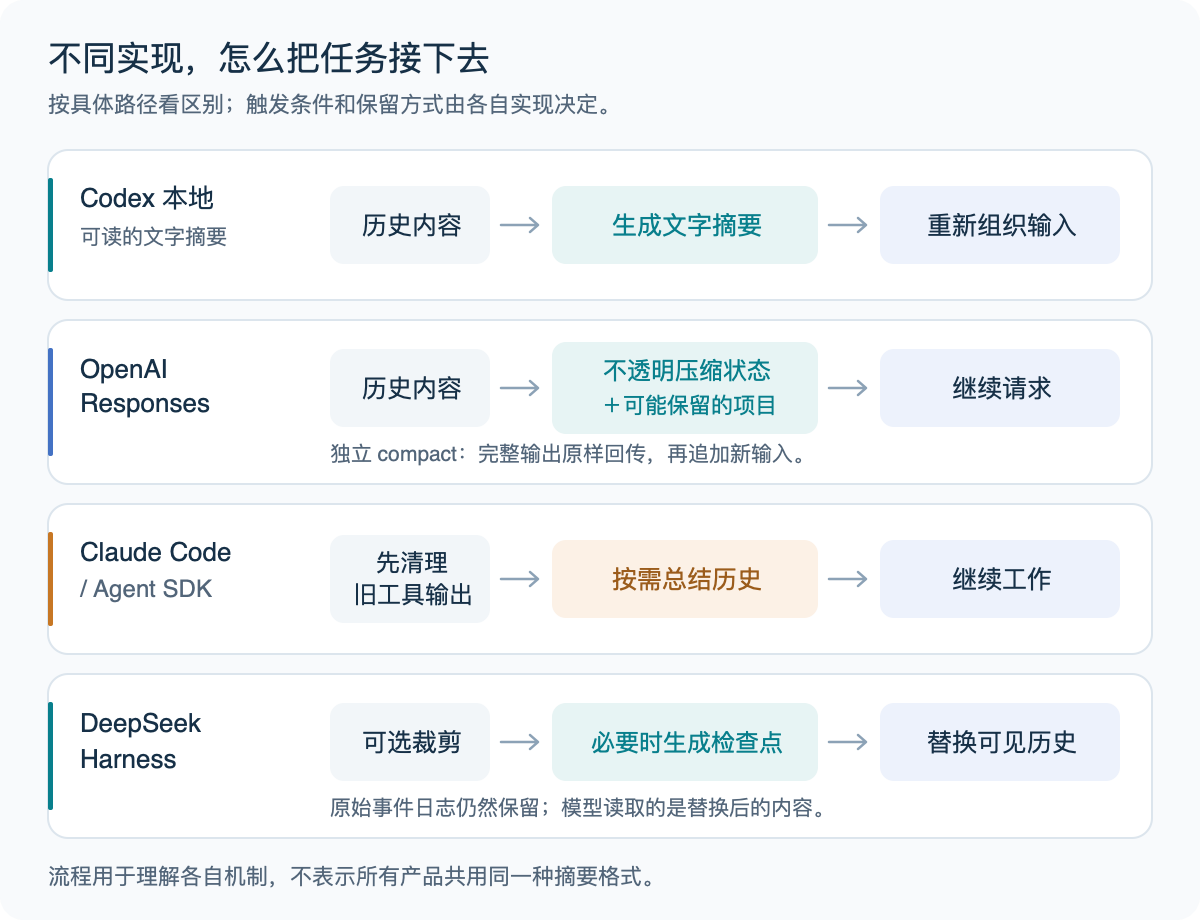
这几种方式都在为后续工作腾空间,但触发条件和保留方式有区别。把 DeepSeek 模型接到其他 Agent 工具里,也要看那个工具怎么管理上下文,不能直接套用 DSH 的实现。
5. 压缩完成,不代表所有问题都解决了
5.1 上下文变短,仍然可能漏掉重要信息
文本摘要需要选择哪些内容留下。提示词要求保留用户约束,也不代表每次生成都能做到零遗漏。
比如只保留“不要用锁”,没留下“这次不处理多标签页”的原因。后面遇到另一个问题,就可能把范围理解错。
判断压缩结果有没有用,可以看它能不能支持接下来的动作:知道要改哪里,知道什么不能改,知道哪些证据还没拿到。
5.2 缓存和压缩处理的是不同问题
Prompt Cache、KV Cache 这类缓存,主要复用已经处理过的计算。匹配的前缀命中缓存,不等于这部分内容就从逻辑输入里消失了。
上下文压缩则会改变后续带入的内容,减少需要占用的空间。两者可以配合使用,但不能因为有缓存,就认为窗口不会满。
5.3 少了 token,也不一定马上省钱
生成摘要本身需要调用模型,会消耗时间和 token。修改历史内容还可能影响前缀缓存;如果关键内容丢了,后面重读文件、重跑命令,也有额外成本。
所以前面 100,000 变成 38,000 的例子,只表示下一次输入变短。要计算整个任务的收益,还得看后面跑了多少轮、缓存是否命中,以及有没有返工。
6. 平时怎么让 Agent 更容易接着做
如果只是日常使用,没有必要先研究所有压缩参数。可以先把容易丢的东西写清楚。
第一,把长期规则放进项目说明里。 比如代码风格、测试方式、不能新增的依赖,放在工具支持的项目规则文件中,并确认它确实会被加载。当前任务独有的要求,则继续保存在任务记录里。
第二,重要进度留一份能重新读取的记录。 可以是任务文档,也可以是项目里的工作记录。位置要明确,后续继续时让 Agent 读这个文件。“参考前面的讨论”很难定位到具体证据。
第三,记录失败和未完成的验证。 代码改完了,就写“已修改,尚未重跑测试”。测试通过了,再写清楚跑了哪些检查。不要只留一句“已修复”。
如果要手动整理交接记录,用下面这些项目就够了:
1 | |
压缩以后,可以先让 Agent 对照当前文件和测试记录确认一下状态。尤其是准备继续修改、提交结果之前,检查摘要里写的事情和实际工作区是否一致。
以上。完结撒花 🎉!