本地跑大模型,7B、4bit 和显存到底是什么关系?
准备在自己的电脑上跑一个模型,下载页面上先出现一串名字:7B、8B、Q4、Q8、GGUF。再看看文件大小,好像也不算大,下载下来却发现内存不够,或者回答慢得让人着急。
这些名字分别在说什么?模型文件只有几 GB,为什么运行时还要更多内存?这篇把几个容易混在一起的概念拆开,最后用一个小模型看一下本地运行的过程。
1. 7B 说的是参数数量
模型名字里的 B 是 billion,也就是十亿。通常说一个 7B 模型,是说它大约有 70 亿个参数。名字往往是规模标记,精确数量还要看模型信息。
这些参数可以理解为训练过程中得到的一大批数值。运行模型时,程序要读取这些数值,参与计算。
参数多,通常需要存放的数据也多。但只看参数量,不能直接判断两个模型谁更好用。训练数据、模型结构、训练方式,以及你要做的任务,都会影响结果。
比如只是整理一段文字,用一个小模型就可能够用。要处理复杂代码,除了能不能装进去,还得检查它实际能不能完成任务。
另外,有些模型使用 MoE 结构,名称里会同时出现总参数和激活参数。每次计算只用到部分参数,不代表其他权重就完全不用存放。遇到这种模型,要分别看计算量和运行时的加载方式。
2. 4bit 说的是数值怎么存
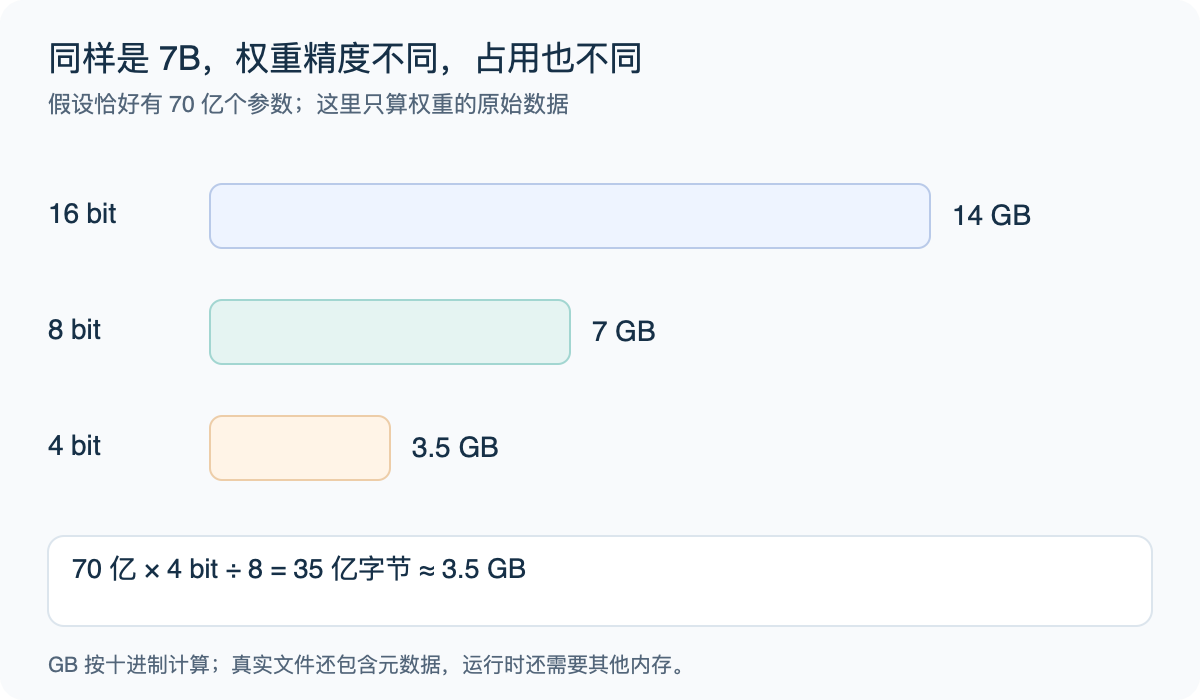
同样的参数,可以用不同精度保存。粗略算权重占用,可以用这个公式:
1 | |
拿一个假设恰好有 70 亿参数的模型来算:
| 存储精度 | 只计算权重的大小 |
|---|---|
| 16bit | 约 14 GB |
| 8bit | 约 7 GB |
| 4bit | 约 3.5 GB |
这里使用十进制 GB。3.5 GB 大约是 3.26 GiB,有的系统界面显示的是后一种单位。
把权重从较高精度转换到较低精度,通常就叫量化。它能减少存储和内存占用,但数值表达也会发生变化,效果要看量化方法和具体模型。
实际文件不会总是刚好等于上面的结果。量化还要保存缩放系数等信息,有些部分会使用更高精度。像 Q4_K_M 这样的名字,表达的是一种具体量化方案,不能简单当成“整个文件里每个数字都严格占 4 位”。
GGUF 则是常见的模型文件格式。它可以装不同量化方式的权重。看到 .gguf,还要继续看里面是什么模型、用了什么精度。
这里说的权重量化,处理的是模型参数;前面聊过的上下文压缩,整理的是对话和任务记录。两件事可以同时使用,但减少的东西不同。实际推理系统里,也可能另外对 KV 缓存等数据做量化。
3. 模型文件装下了,运行空间还没算完
运行模型时,除了权重,还会占用其他空间:
- KV Cache:保存注意力计算中后续会重复用到的中间数据。
- 激活值和工作缓冲区:计算过程中临时使用的空间。
- 运行框架的额外开销:具体大小和软件、后端、设置有关。
因此,一个权重粗估为 3.5 GB 的模型,不能直接得出“有 4 GB 显存就一定能完整跑起来”的结论。
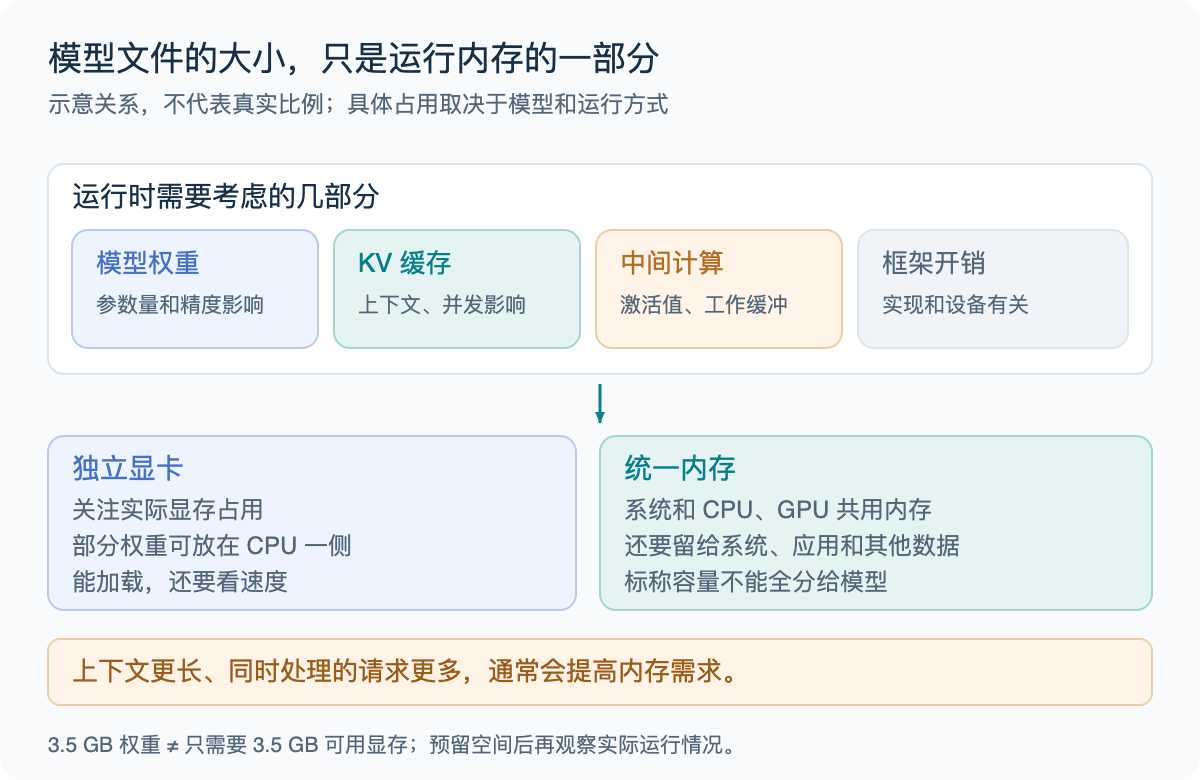
上下文长度也要算进去。相同模型接收更长的内容,或者同时处理更多请求,通常需要更多缓存和工作空间。有的程序会预先分配,有的会逐步增长,不能只盯着刚加载完成时的数字。
如果模型宣传支持很长的上下文,也不代表自己的机器应该直接把设置拉满。先满足当前任务,再看内存够不够。
独立显卡主要看专用显存。Apple Silicon 这类统一内存设备,CPU 和 GPU 共享内存池,系统和其他软件也要使用它。比如一台 16 GB 统一内存的电脑,不能直接当成有 16 GB 可全部交给模型的独立显存。
4. 能跑起来,和用起来顺手是两回事
部分推理程序支持把模型分放在 GPU 和 CPU 上。显存不够时,借助系统内存仍可能运行,但速度会受到计算能力和数据传输的影响。
看运行体验时,可以分开观察:
- 模型加载时间:权重从存储加载进来需要多久。
- 开始回答前的等待:输入越长,需要处理的内容通常也越多。
- 后续生成速度:开始输出以后,每秒能继续生成多少内容。
不能只看到“成功输出了一句话”,就认为它适合整天处理长文档或代码仓库。
量化也不保证在所有设备上都更快。硬件和推理后端是否支持相应运算,同样会影响结果。最有用的比较,是在自己的机器上,用同一组任务观察效果、速度和占用。
5. 先用一个小模型看清运行过程
下面用 Ollama 和 qwen3:0.6b 做操作示例。这个模型比较小,适合先熟悉下载、加载和查看状态。这里不提供速度排名,也不把它当成复杂任务的能力推荐。
安装并启动 Ollama 后,先确认命令能用:
1 | |
然后下载模型,并查看模型信息:
1 | |
show 用来确认当前模型的信息,包括参数规模、量化方式和支持的上下文长度等。标签对应的具体文件可能更新,实际信息以自己下载到的版本为准。
开始对话:
1 | |
可以先输入一个短任务:
1 | |
再开一个终端查看当前加载的模型:
1 | |
留意模型占用、处理器分配和上下文配置。再配合系统的内存监控,看看加载前后发生了什么变化。这里的运行占用和下载文件大小,不应当预期完全相同。
如果显示有部分计算放在 CPU 上,就要把系统内存和 CPU 的负担一起考虑。也不要把一张显卡上的表现,直接套到另一台机器上。
体验结束后,可以卸载当前正在内存里运行的模型:
1 | |
这一步停止运行,不会删除已经下载的模型文件。
6. 选模型时,按这个顺序来
先确定任务,再选模型规模和量化版本。拿几份自己真的会处理的材料,看看它能不能完成,而不是只问一个很简单的问题。
接着设置够用的上下文,留出系统和其他软件的空间。如果出现占用过高,可以分别检查模型规模、量化精度、上下文长度和并发数量,别只盯着一个参数。
最后再比较速度。记录模型标签、量化方式、上下文设置和设备,换配置时尽量只改一项。这样才知道到底是哪一步带来了变化。
以上。完结撒花 🎉!