文档都给 AI 了,为什么还是答错?聊聊 RAG
把自己的文章、项目文档传进知识库,界面也提示上传成功了。接下来问一个文档里明明写过的问题,AI 却答错了,或者直接说没找到。
这时候,先看看它到底拿到了哪段内容。文档放进系统里,和回答时真正用上这段文档,中间还有好几步。
这篇就用个人博客里的 PVE 文章做例子,看看 RAG 是怎么找资料的,以及出问题以后应该从哪里查。
1. RAG 做的是先查资料,再回答
RAG 的全称是 Retrieval-Augmented Generation,中文通常叫“检索增强生成”。名字有点长,过程很好理解:
你提出问题,程序先到资料里查一遍,把相关内容取出来,再交给模型组织回答。
比如你问:“两台没组集群的 PVE 服务器,怎么迁移虚拟机?”
系统需要先找到讨论这个场景的文章,再拿里面的准备工作、迁移过程和限制条件来回答。它不需要把整站所有博客都塞进这一次请求。
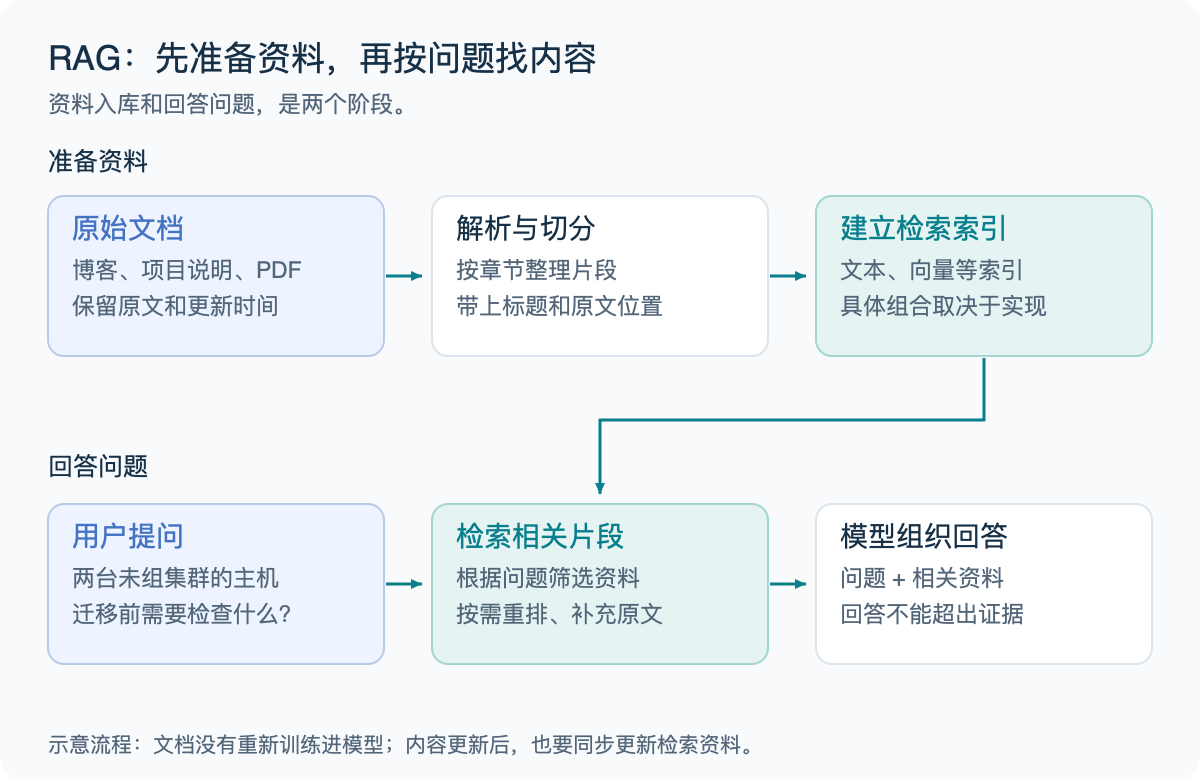
这里没有把文档重新训练进模型参数。资料是回答时临时找出来、放进上下文的。文档更新了,也需要让检索系统同步到新内容,模型不会因为你改了本地文件就自动知道。
另外,上传文档不一定就用了 RAG。文件很短时,应用可以直接把全文放进上下文;也可以先读取,再按问题搜索。具体怎么做,要看应用的实现。
2. 文档进了知识库,还要整理成能找到的内容
2.1 切分时要留下完整意思
一篇长文章,通常会拆成多个片段,也就是 chunk。检索时先找片段,避免一个小问题带出整篇长文。
但切分不是随便每隔几个字断一下。标题、前提和正文分开以后,一个片段可能就看不明白了。
下面两段是为了说明问题写的示例,不是实际迁移步骤:
1 | |
下面这句话讲的是哪种迁移,已经不清楚了。它也可能出现在数据库迁移、容器迁移的文章里。
更合适的做法,是让片段带上文章标题、小节名称,必要时保留相邻内容。代码块、表格和操作步骤也尽量保持完整。
片段太小容易丢前提,太大又会带入很多无关内容。没有一个长度适合所有文档,先按标题和自然段切,再拿实际问题检查效果。
2.2 原文位置和版本也要一起保存
除了正文,建议给片段保留这些信息:
| 信息 | 后面有什么用 |
|---|---|
| 文章名称、小节 | 让片段有上下文 |
| 文件路径、片段编号 | 找回完整原文,定位切分问题 |
| 更新时间、适用版本 | 避免把旧做法当成当前做法 |
| 文档类型或权限范围 | 缩小检索范围,避免取到不该读取的资料 |
比如你问的是 PVE,先把范围限制在相关文档,比在所有文章里寻找“迁移”更准确。资料内容更新以后,还要替换旧片段,不能一直把新旧版本堆在一起。
3. “找得像”和“找得对”,还有一点距离
3.1 向量检索按意思找
Embedding 可以把一段文本转换成一组数字,用来比较文本之间的相关程度。向量检索会根据这种表示寻找相似内容。
所以你问“把虚拟机搬到另一台机器”,也有机会找到写着“PVE 虚拟机迁移”的文章,文字不用完全一样。
不过,相似只是在帮忙筛候选。介绍集群内迁移的文章,和介绍非集群迁移的文章,看起来都很相关,但适用条件不一样。检索分数高,也不等于这段内容一定能回答问题。
3.2 关键词检索适合找准确名称
如果问题里有具体命令、错误码或者文件名,关键词匹配往往很有用。比如你明确问到 vzdump,就应该重视这个词,而不是只找大致有关备份的段落。
所以常见做法是两边都查:一边按意思找,一边按关键词找,再把结果合并、去重。这叫混合检索。RAG 也可以只使用普通文本搜索,并不要求一定搭一个向量数据库。
3.3 重排再检查一次相关程度
第一轮可能找出不少候选。重排,也就是 rerank,会结合当前问题,重新给这些候选排序,尽量把真正相关的片段放到前面。
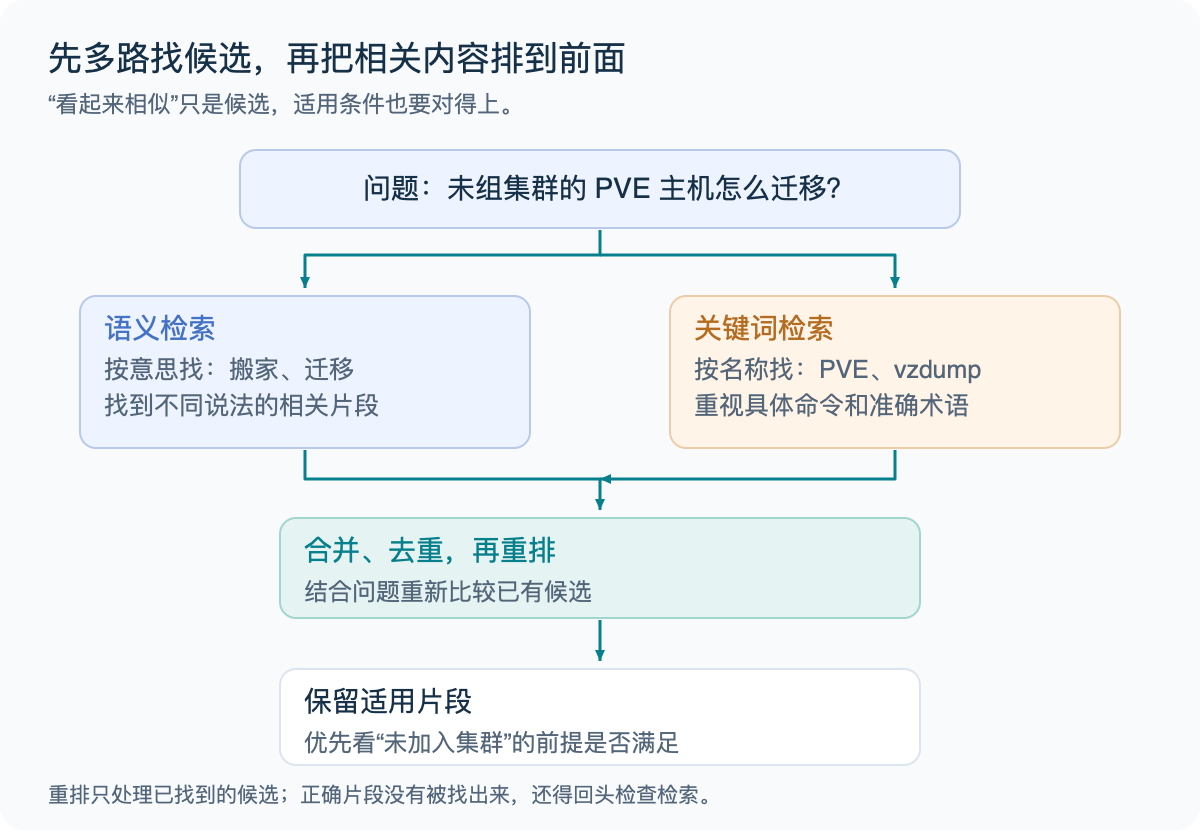
这里的例子里,“未加入集群”是重要条件。候选里即使出现很多次“迁移”,如果讲的是另一种场景,也不应该排在最前面。
重排只能处理已经找到的候选。正确文档根本没有进候选列表时,后面再怎么排序,也排不出它。
4. 找到片段后,再交给模型回答
到了这一步,模型拿到的通常是:用户问题、回答要求,以及检索出来的几段资料。
如果这些片段只讲了迁移前检查,没有操作步骤,那么当前资料只能支持准备工作。比较合适的处理,是继续查找后面的章节,或者说明还缺少哪些信息。
不要让模型为了凑出一套完整教程,把没查到的命令自行补上。运维内容尤其要注意版本和操作前提,步骤看起来顺畅,并不能证明它适用于当前机器。
也不是片段越多越好。把五种不同环境的做法一起交过去,模型还需要分辨它们。可以先按场景过滤,再保留回答需要的内容,必要时读取对应章节的前后文。
5. 答错以后,按顺序往前查
如果只看最后一段回答,很难知道问题出在哪。建议先保留检索候选、最后带入的片段,以及模型的回答,按下面的顺序检查。
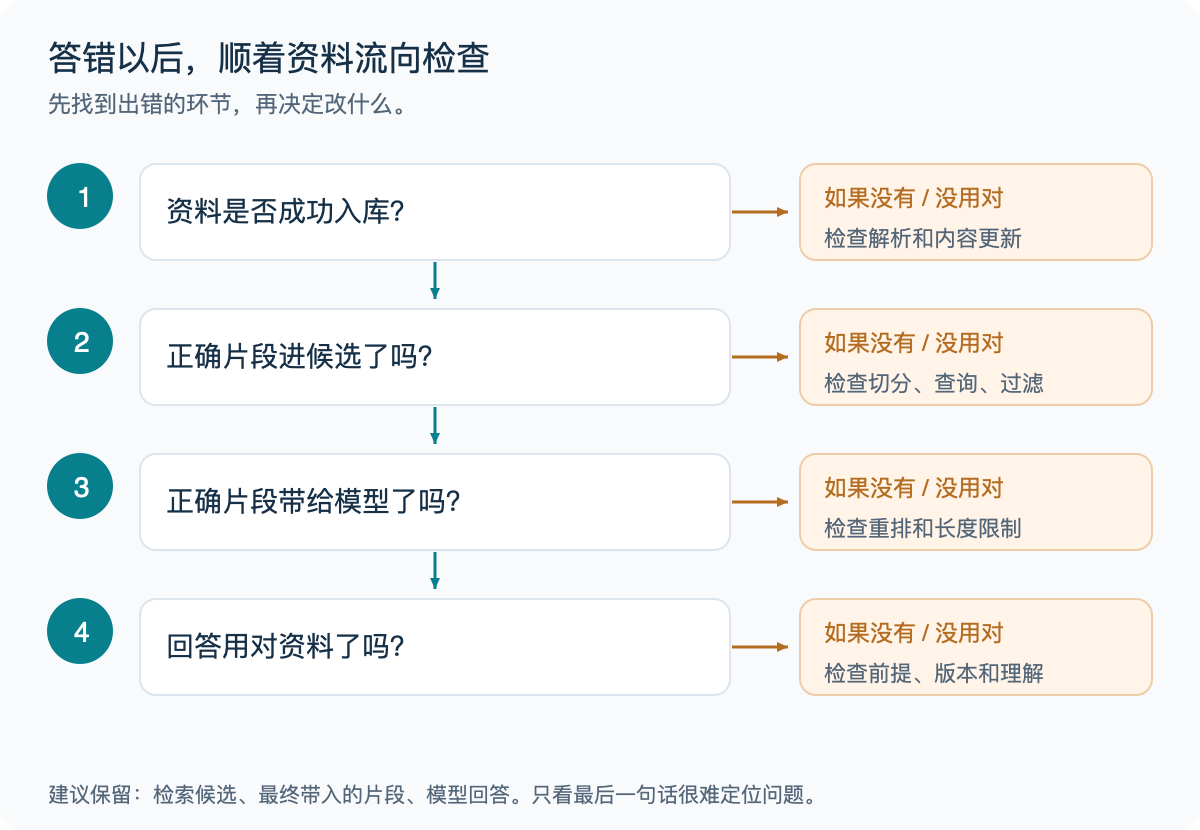
| 看到的情况 | 优先检查什么 |
|---|---|
| 知识库里没有相应内容 | 文件解析是否成功,内容是否更新到索引 |
| 原文有,候选列表没有 | 问法、切分方式、关键词、过滤条件 |
| 候选里有,最后没带入 | 重排顺序、片段数量和长度限制 |
| 带入了,回答仍然不对 | 前提是否完整,是否混入旧版本,模型有没有误读 |
比如 PDF 里明明有一张表,但解析结果把表头和数值拆散了。这个问题在整理资料时就出现了,后面换提示词不一定能解决。
又比如只问“怎么迁移”,系统不知道你有没有集群。可以先补充环境,再查。问题本身缺条件,也可能让检索往错误方向走。
6. 先拿几道自己的问题试一遍
做个人知识库,可以先从少量文章开始。挑一些答案位置明确的问题,再加上文档里没有答案的问题。
比如用下面这组来检查:
1 | |
每次调整切分或者检索方式,都用同一组问题再查一次。看正确片段有没有找到,回答有没有用对,别只比较最后那段话是不是更好看。
先把“文档在哪、找到了哪段、回答用了什么”这条线查清楚,知识库出问题时就有地方下手了。
以上。完结撒花 🎉!