一句“帮我查一下”,AI 是怎么真的去查的?
让 AI 帮忙看一个项目,它可能会先读文件,再执行命令,最后告诉你哪里有问题。界面上看起来,是 AI 自己一步步把事情做完了。
但模型输出的文字,怎么变成了真正的文件读取和命令执行?工具返回以后,它又怎么知道下一步做什么?
这篇拿一个很小的任务来拆开看:查一下这个博客项目使用的 Hexo 版本。任务不复杂,但工具调用里几个关键环节都有。
1. 先把“想调用”和“实际执行”分开
大模型可以根据上下文,生成一份结构化的工具调用请求。比如要调用哪个工具,传入什么参数。
真正去读取文件的,是接收这份请求的程序。这里把它叫作宿主程序,也就是运行 Agent 的那套应用。工具也可能由服务提供商在服务器上执行,具体要看工具类型。
以本地文件工具为例,整个过程大概是这样:
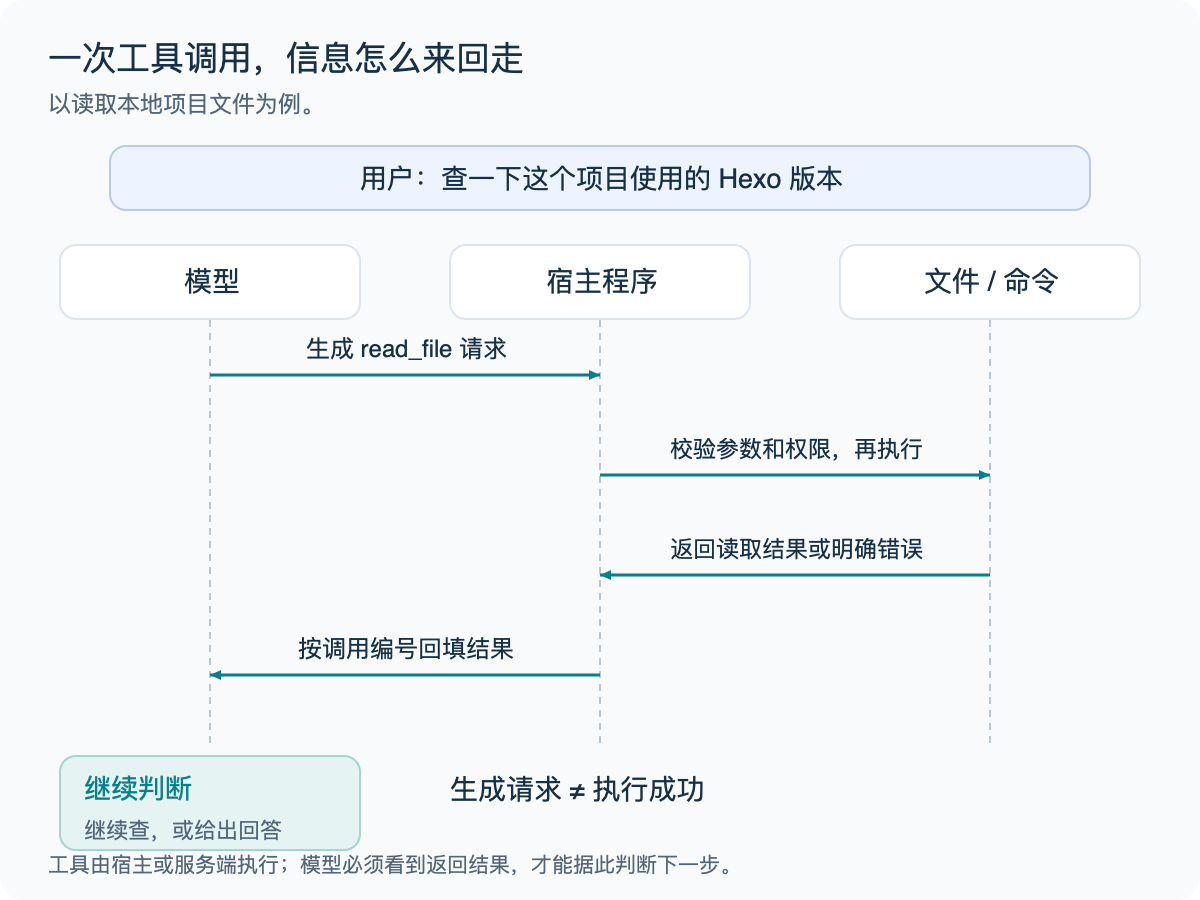
模型生成了调用请求,只能说明它准备这样做。请求是否被允许、文件是否存在、读取是否成功,都要等执行结果回来以后才能知道。
比如它生成了 read_file 调用,但程序根本没接这个工具,就不会自动读到文件。
2. 工具说明告诉模型,有什么可以用
模型需要知道当前有哪些工具,每个工具干什么,参数应该怎么填。工具说明通常包括名称、用途和参数结构。
下面是一个简化的定义,用来说明结构,不是某个产品的完整接口:
1 | |
看到“查一下项目用的 Hexo 版本”,模型可能判断先读 package.json。它接着生成的内容,可以抽象成:
1 | |
这里的 call_id 用来对应本次调用和后面的结果。实际接口的字段名会有区别,但总要能分清结果属于哪一次请求。
工具描述也会影响选择。如果两个工具都只写着“查询信息”,模型就不容易知道该选哪个。说明里最好写清楚查询对象、参数含义和返回内容,不用堆一大段宣传式介绍。
3. 程序接到请求以后,要负责把事做对
宿主程序收到请求,应该先检查工具是否存在、参数格式是否符合要求,再按应用的权限规则决定是否执行。
比如这里的 path 是字符串,不代表它就一定属于当前项目。程序仍然要解析路径、检查允许范围,再读取文件。只在工具描述里写“只能读项目文件”,并不能代替代码里的限制。
执行完成以后,把结果和调用编号一起返回。结构可以简化成这样:
1 | |
如果文件不存在,就应该返回明确的失败结果。不能把读取失败当成空文件,再让模型猜里面原本写了什么。
结果能说明多少,就回答多少。 对这个例子来说,读到 ^7.3.0,还不能直接说本机实际运行的版本就是 7.3.0。
4. 查版本这个小任务,可能也要调用几次工具
package.json 里的依赖声明是:
1 | |
这里的 ^7.3.0 是允许安装的版本范围。按通常的语义版本规则,它允许 7.3.0 及以上、低于 8.0.0 的稳定版本。它不是“当前安装版本”的证明。
还可以继续看另外两处:
| 想知道什么 | 看什么 |
|---|---|
| 项目允许哪些版本 | package.json 的依赖声明 |
| 这份锁文件记录了哪个版本 | 对应包管理器的锁文件 |
| 当前目录实际解析到哪个版本 | 已安装依赖中的包信息,或相应版本查询结果 |
例如,在已经安装依赖的项目目录里,可以读取实际包信息:
1 | |
假设返回 7.3.0,那么现在有证据说明:当前项目环境解析到的 Hexo 包版本是 7.3.0。如果没有安装依赖,这条命令可能失败;此时只能先说明声明范围和锁文件记录。
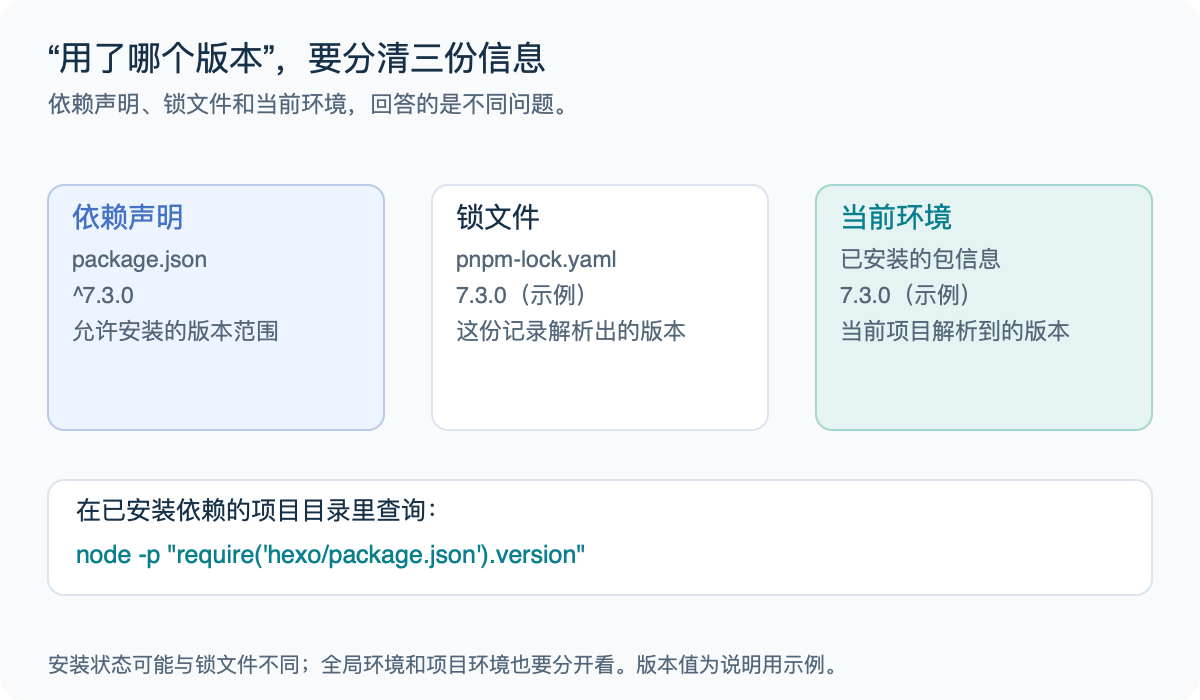
这就是工具调用需要循环的原因。第一次结果可能只回答了一部分问题,模型看完以后,还需要决定要不要继续查。
全局安装的 Hexo、项目里的 Hexo,也可能不同。查询时工作目录和所用命令要对应,不能在另一个目录跑出结果,就拿来回答这个项目。
5. Agent 循环,就是把结果再交回去
把前面的过程写成伪代码,大概是这样:
1 | |
实际程序还要处理超时、取消、多个调用,以及接口要求的消息顺序。不过最关键的往返就在这里:模型决定下一步,程序执行,再把结果交回模型。
工具出错以后,也不一定要原样重试。文件路径错了就修路径,权限不足就停止相应操作,网络暂时失败才考虑有限重试。对于会产生修改的工具,还要确认上次到底有没有执行成功,避免重复操作。
当现有结果足够回答问题,模型就可以停止调用。应用也应该有自己的限制,避免一个小任务一直查下去。
6. 那 MCP 在哪个位置
前面这种“模型提出请求,程序执行工具,再返回结果”的过程,通常叫工具调用,也经常看到 Function Calling 这个名字。
MCP 解决的是应用如何用统一协议连接外部工具和资料。它可以让宿主程序发现服务器提供了哪些工具,再把调用转发过去,接回结果。
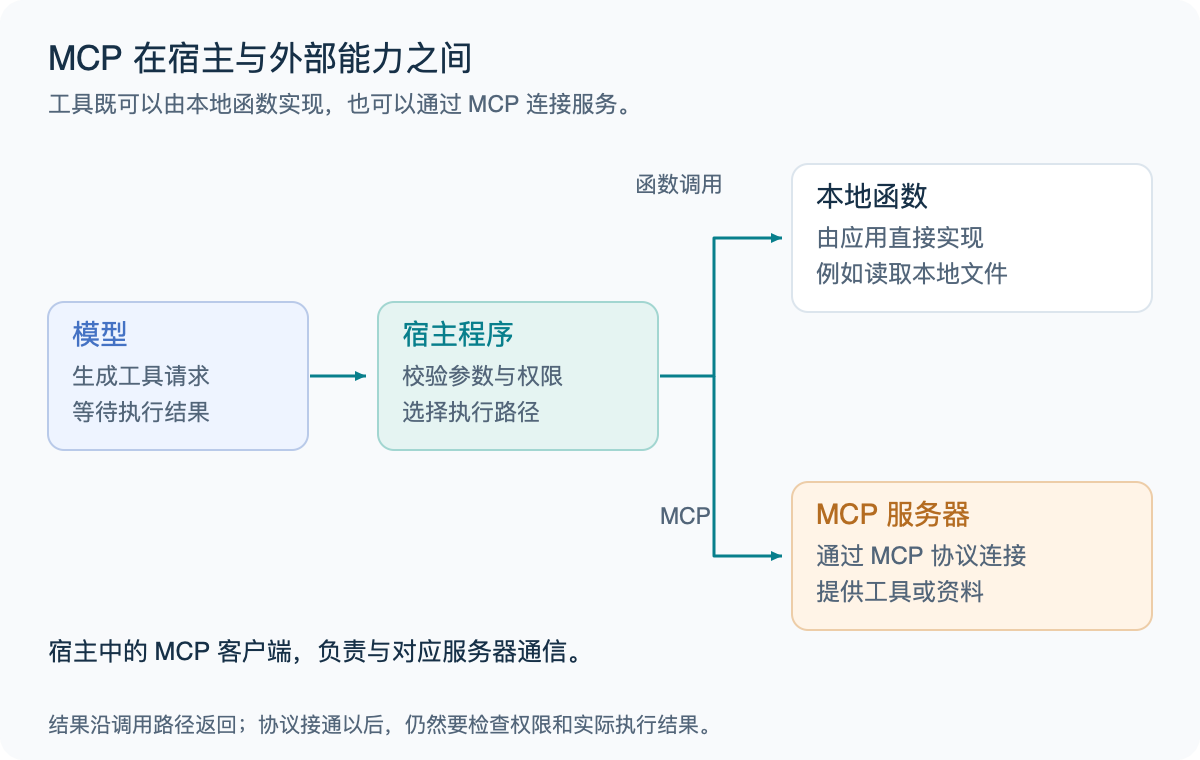
工具可以直接由应用里的函数实现,也可以经过 MCP 连接到一个服务。两种方式都能参与同一套 Agent 工作流程。
所以装了 MCP 服务,还要看宿主有没有连上、工具有没有暴露给模型、权限是否允许,以及实际调用是否成功。协议接通只是其中一步。
以后再看 Agent 的执行记录,可以顺着这几个位置读:它请求了什么,程序执行了什么,返回了什么证据,最后的回答有没有超出证据。
这样就容易分清,问题到底出在工具选择、执行过程,还是模型对结果的理解上。
以上。完结撒花 🎉!