AI 说“已经完成”,怎么判断它真的做完了?
让 AI 改一段代码,最后收到一句“已修复,测试通过”。听起来没有问题,但打开页面,换个输入,问题又出现了。
这时候需要看的,是它到底改了什么、跑了哪些检查,以及这些检查能不能证明你的要求已经满足。最后那段完成说明,可以作为线索,不能代替结果本身。
下面用一个分页函数,把从提出要求到验收结果的过程走一遍。
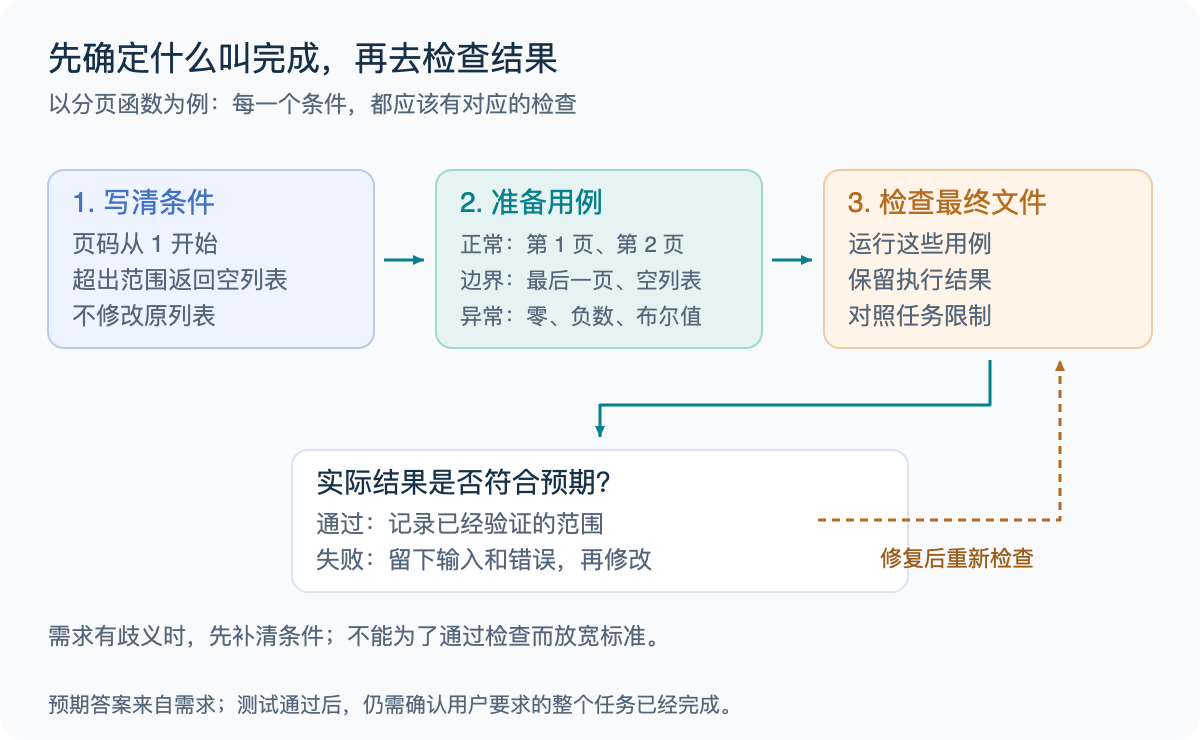
1. 先把“完成”写成可以检查的条件
假设让 AI 写一个函数,把列表按页返回。只说“帮我做个分页”,还有很多细节没有确定:
- 页码从 0 开始,还是从 1 开始?
- 最后一页不够一页时怎么处理?
- 页码超出范围,要返回空列表,还是报错?
page=0、size=-1算不算有效输入?
这些问题不写清楚,代码即使能运行,也可能和你的预期不同。
这次可以把要求定成下面这样:
1 | |
这一步很关键。后面的检查应该围绕这些条件设计,不能只照着 AI 刚写出的代码验证一遍。
2. 正常输入,只能证明一小部分事情
先用一组容易看清结果的数据:
1 | |
如果只检查第一页,很多有问题的实现也能通过。比如最后一页切片位置写错,或者越界时抛异常,都不会在第一页暴露出来。
建议先分三类准备输入:
| 类型 | 这次检查什么 |
|---|---|
| 正常情况 | 第一页和中间页的元素是否正确 |
| 边界情况 | 最后一页、空列表、超过最后一页 |
| 异常情况 | 零、负数、小数、字符串和布尔值 |
还有一项不能只看返回值:原列表有没有被修改。返回结果正确,却把调用方的数据改掉了,也不符合这次要求。
用例里的预期结果,最好先根据需求手工算出来。不要让测试再用同一套分页公式计算“正确答案”,否则实现和测试如果一起把页码算错,两边仍然可能相等。
例如第一页应该是 [1, 2],这个结果直接写进用例就可以。测试的目的,是拿一个独立的答案检查实现,不是把实现换个地方再写一次。
3. 用一段能运行的代码检查
下面是一份满足上述约定的实现。保存为 page_demo.py:
1 | |
这里有个 Python 的小细节:bool 是 int 的子类。如果只使用 isinstance(page, int),True 也会被接受。我们前面明确要求拒绝布尔值,所以这里检查具体类型。
再把下面的检查代码追加到同一个文件末尾:
1 | |
运行:
1 | |
这份示例包含 8 个测试方法,其中一些会检查多个输入。正常情况下会显示 Ran 8 tests 和 OK。
它证明的是这组检查通过了,不代表所有可能的输入都已经覆盖。例如这里没有要求深拷贝列表内部的对象,也没有实现数据库分页。后续需求增加,验收条件和用例也要跟着补。
4. 测试通过以后,还要对照任务本身
如果用户要求的是“修好文章列表的分页”,上面的函数测试只是其中一层。
还需要确认页面实际调用了这个函数,按钮传入的页码正确,最后一页不会重复显示数据。只把函数写好,却没有接到页面上,任务仍然没完成。
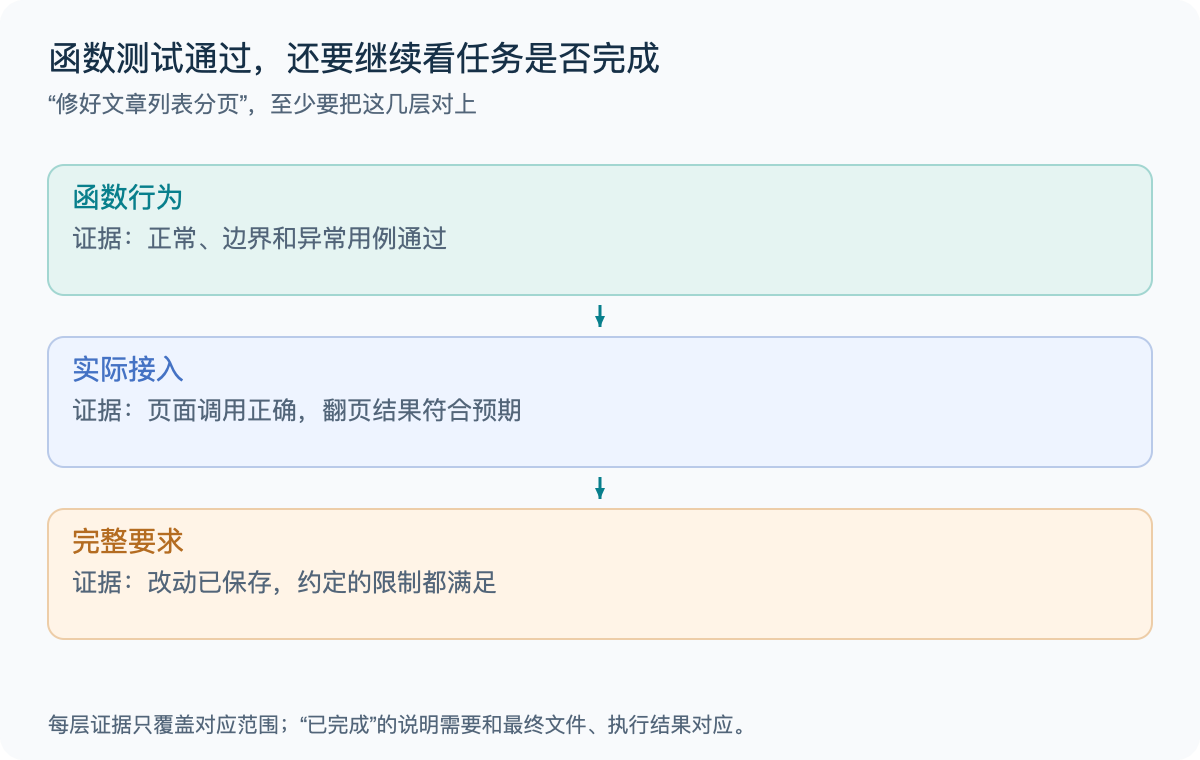
可以把交付检查分开看:
- 文件状态:目标文件有没有修改,修改是否保存在当前工作区。
- 代码行为:测试到底覆盖了哪些输入,执行结果是什么。
- 使用结果:真正打开页面或者调用接口,行为是否符合要求。
- 任务限制:有没有顺手增加依赖、修改无关接口,或者漏掉其他明确要求。
这几项并不是每次都要弄得很复杂。只改一句文案,直接看页面通常就够了;改分页逻辑,才需要正常和边界用例。检查要和变化对应。
还要注意检查发生在什么时候。AI 跑完测试,又修改了一次函数,之前的通过记录就不能代表最终文件。最后一处修改影响到什么,就重新检查对应部分。
如果检查失败,先留下实际输入、预期结果和错误信息,再继续修改。这样下一轮有明确的问题可以复现,也能确认改动确实解决了这个问题。否则来回改几次,很容易只记得最后那句“现在应该好了”。
5. 让 AI 检查自己,也要给它具体标准
“再检查一下有没有问题”太宽泛,可以换成明确的检查任务:
1 | |
另一个 Agent 可以帮忙独立审阅,但也可能重复同样的理解错误。能用程序确定的结果,优先运行程序;需要判断的内容,再让人或模型按明确标准检查。
如果是在比较提示词、模型或者整套 Agent 流程,还可以固定一组任务反复运行,记录完成情况、时间和消耗。这里评估的是整段工作过程,比单个函数测试多了一层。一次成功只能说明这一次成功,不能直接推成长期稳定。
6. 写文章、做表格,也可以这样验收
不写代码时,同样可以把要求落到结果上。
比如这次写博客:文章是不是完整的,例子前后有没有矛盾,配图是否能加载,正文有没有保留不需要的引用,语气是不是接近已有文章。这些都能逐项检查。
表格则看字段、行数、公式和合计;资料整理则看关键结论有没有材料支持,以及有没有漏掉限定条件。
像语气、可读性这类没有唯一答案的要求,可以先拿自己满意的两三篇文章做对照。比较开头怎么切入、解释有没有绕远、例子够不够具体,比只给一个“像不像”的分数更容易改。能明确判断的项目单独列出来,主观判断也写清原因。
最后的完成说明,建议写清“完成了什么、检查了什么、还缺什么”。只要还有没验证的部分,就直接写出来,后面才知道该从哪里继续。
以上。完结撒花 🎉!